指示から完成まで、ワンチャット。
「3号雨水ポンプの3Dボックスをクリックしたら、点検手順の動画を再生して、高温注意の警告画像も表示してください」。この一文だけで、AIエージェントは空間の構造を読み取り、対象コンポーネントを特定し、複数のアクションを連結してトリガーを構成します。実行したツール呼び出しはすべて表示され、結果はその場で確認できます。
従来は数日。いまは、数分。
XRの作業手順を1つ用意するのに、これまで何が必要だったのか。
開発・CG制作・AIソリューションなど、複数分野の専門知識が必要でした。
必要なのは自然言語だけ。専門知識はいりません。
AIエージェントができること
編集作業のすべてを、対話だけで。
自然言語で指示
「〜したい」と伝えるだけ。複雑な操作手順を覚える必要はありません。
コンポーネントの自動検索・操作
空間内のタグ、画像、パネル、3Dモデルなどを瞬時に特定して操作します。
トリガー・インタラクション作成
クリックや接近などをきっかけに、動画再生や画像表示などのアクションを自動設定。
アニメーション制御
3Dモデルのアニメーションを、順番や組み合わせを指定して再生できます。
実空間スキャンデータ上で動作
現実の施設をスキャンしたデジタルツイン空間で、そのまま編集が可能です。
多言語対応
日本語・英語・中国語など、使い慣れた言語で指示できます。
マニュアルにできない知識こそ、現場を支えている。
製造現場でいちばん伝わりにくいものに、AIエージェントで挑みます。
暗黙知を「使える知識」に変える3ステップ
空間に紐づけて記録
熟練者の手順・コツ・注意点を、設備の位置とセットでデジタルツインに残します。
AIエージェントが構造化
記録をAIが解析し、検索・質問・教材化ができるナレッジへ変換します。
必要な場所でXR提示
作業のその瞬間に、必要な手順と注意点だけをARで提示します。
AIが「現場の文脈」を理解する。
汎用のチャットボットとの決定的な違いは、空間を理解しているかどうかです。
位置情報
どこにいるか(エリア・設備の位置)
モノ情報
何を見ているか(設備・機器・部品)
人・役割情報
誰が作業しているか(経験・資格・担当)
タスク情報
今、何の作業をしているか(手順・目的)
状況情報
現場の状態はどうか(温度・圧力・異音)
これらを統合して「空間コンテキスト」として理解することで、AIエージェントは“その場・その人・その作業”に最適な情報だけを提示できます。
活用シーン
現場のデジタル教材を、話すだけでつくる
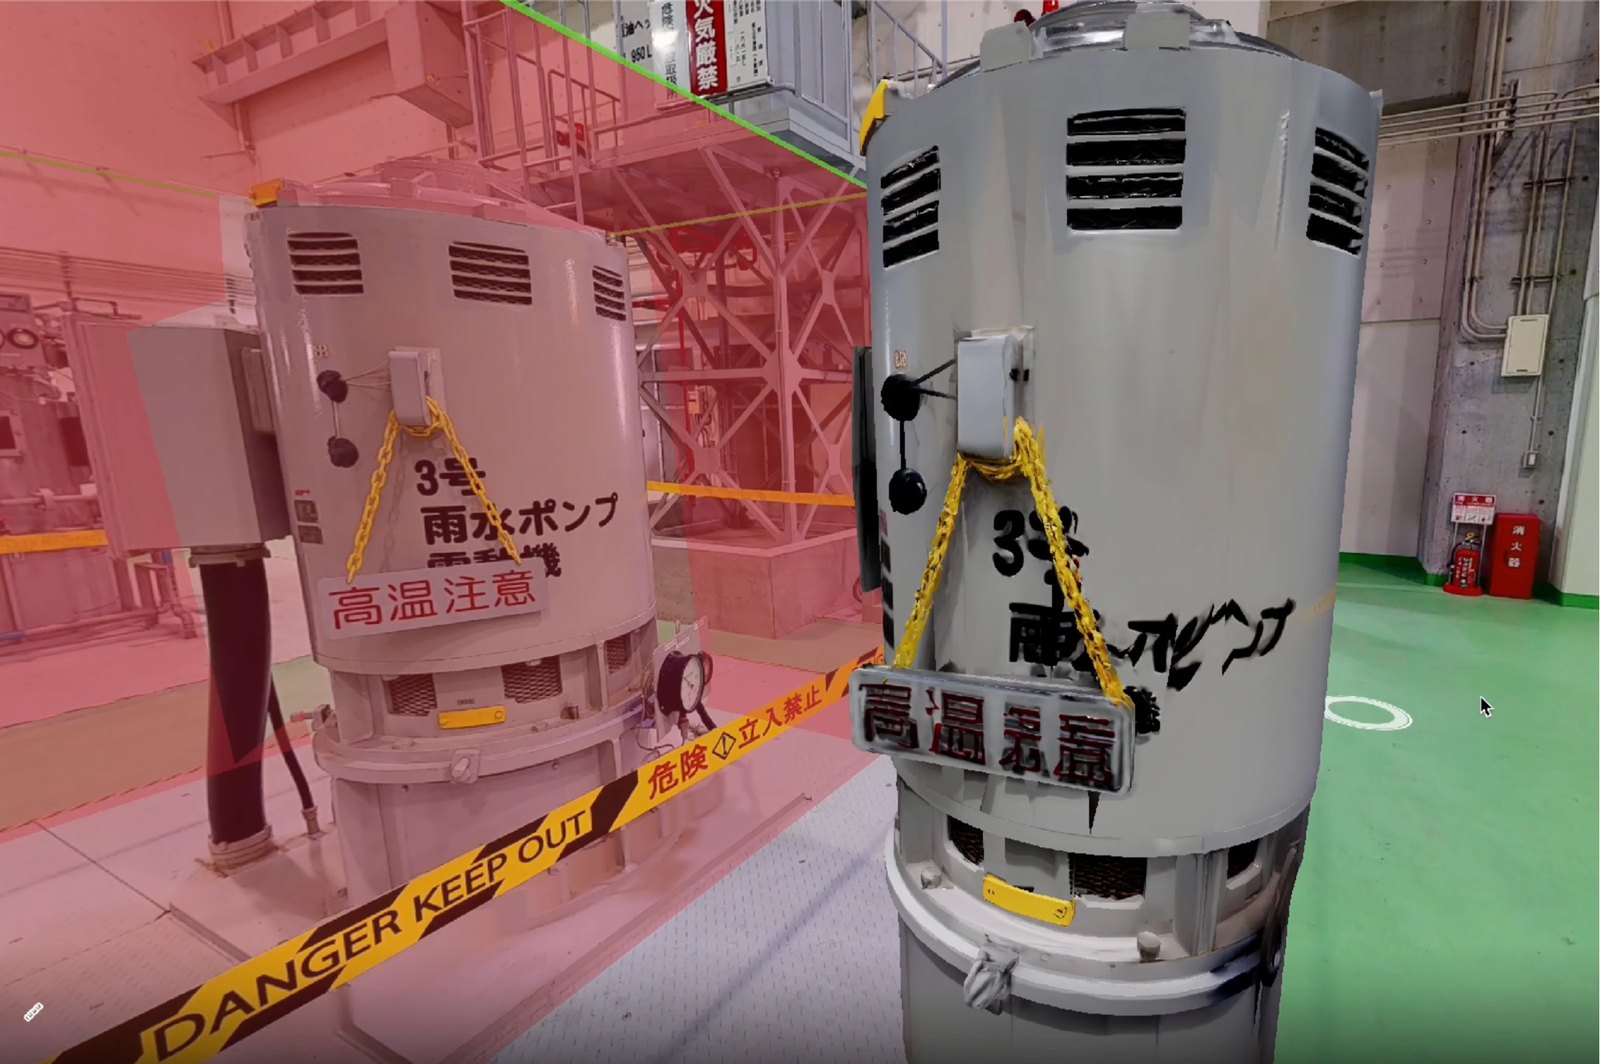
実際のポンプ設備に、操作手順の動画・注意喚起・確認ポイントを紐づけると、現場そのものが教材になります。熟練者の説明を空間に残せるため、新人はいつでも現場と同じ環境で学べます。教材の更新も、話しかけるだけ。
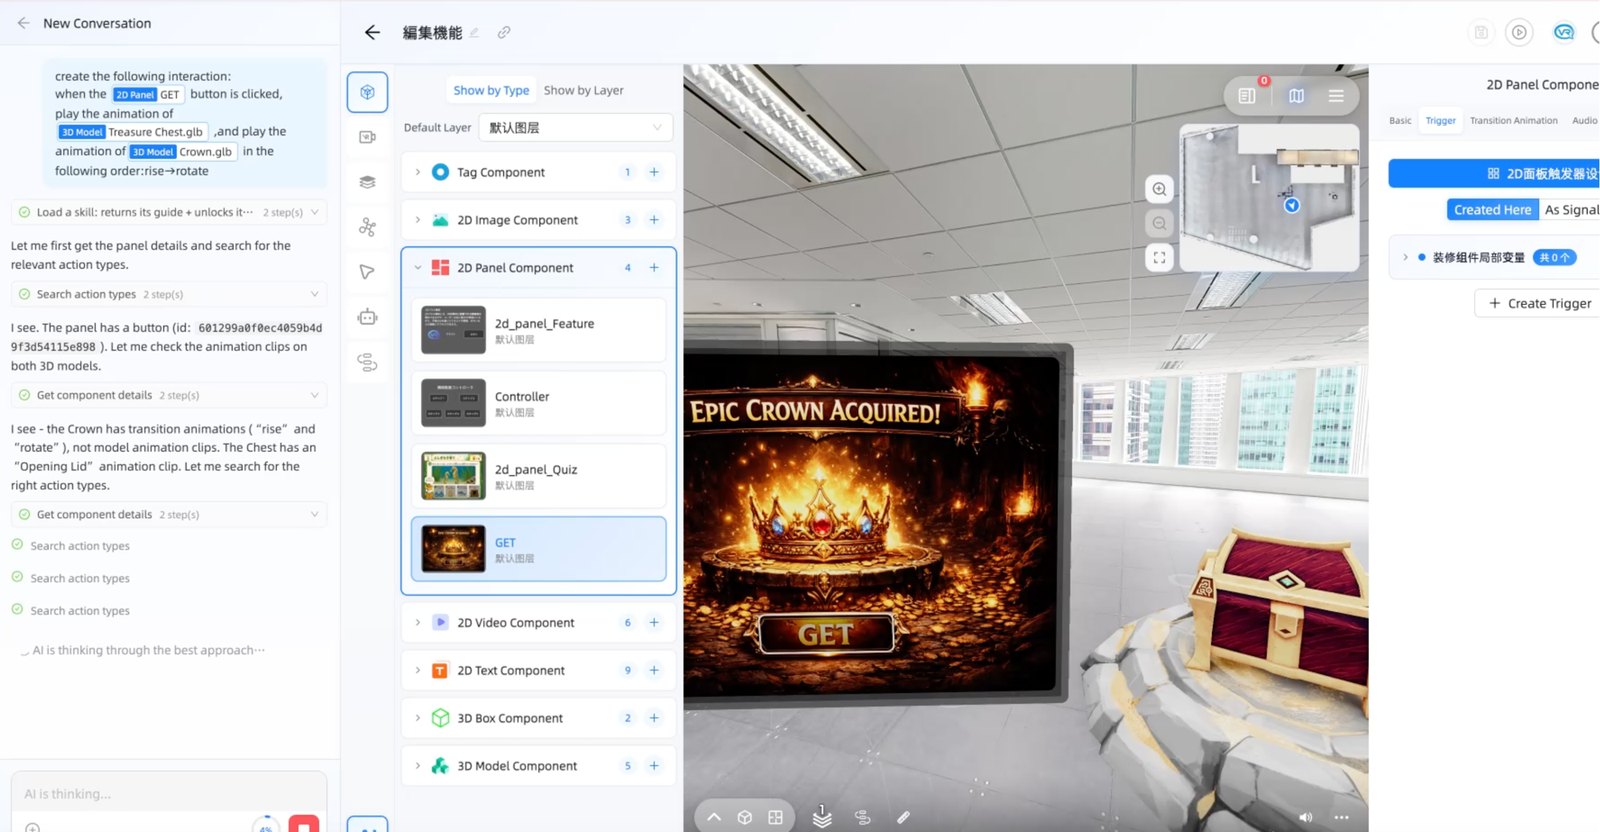
体験型コンテンツを数分で構築
宝箱を開けると王冠が現れる——そんな演出も「GETボタンを押したら宝箱のアニメーションを再生して、王冠を出現させて」と伝えるだけ。
利用の流れ
言葉で伝える
チャットにやりたいことを入力します。
AIが編集
エージェントが空間を解析し、必要な設定を自動で行います。
空間で確認
編集結果はすぐに3D空間へ反映。その場で動作を確認できます。
知識は「読むもの」から「体験するもの」へ。
知識の載せ方が変わると、伝わり方も、学び方も変わります。
人が教える
OJT・口伝・実演。個人の経験に依存し、伝えられる人が限られる。
文書が教える
SOP・マニュアル・動画。標準化はできても、状況に応じた判断は伝わりにくい。
AIが教える
生成AI・ナレッジDB・対話。要約や検索は得意でも、場所と状況の理解は限定的。
空間が教える
位置・設備・タスクをAIが理解し、必要な知識が必要な場所で自然に現れる。
空間コンテキストが、技術伝承を次のステージへ進化させます。
よくあるご質問
エージェントは空間の構造データを直接参照しながら編集します。実行した手順はすべてステップとして表示され、結果はその場で確認・修正できます。